Particul.ai
Extract · Understand · Embed · Search
Her kaynağı anlamlı veriye dönüştürün. Metin, ses, video, görsel, PDF ve web içeriklerini yapay zekâ ile işlenebilir anlamsal parçalara ayırın.
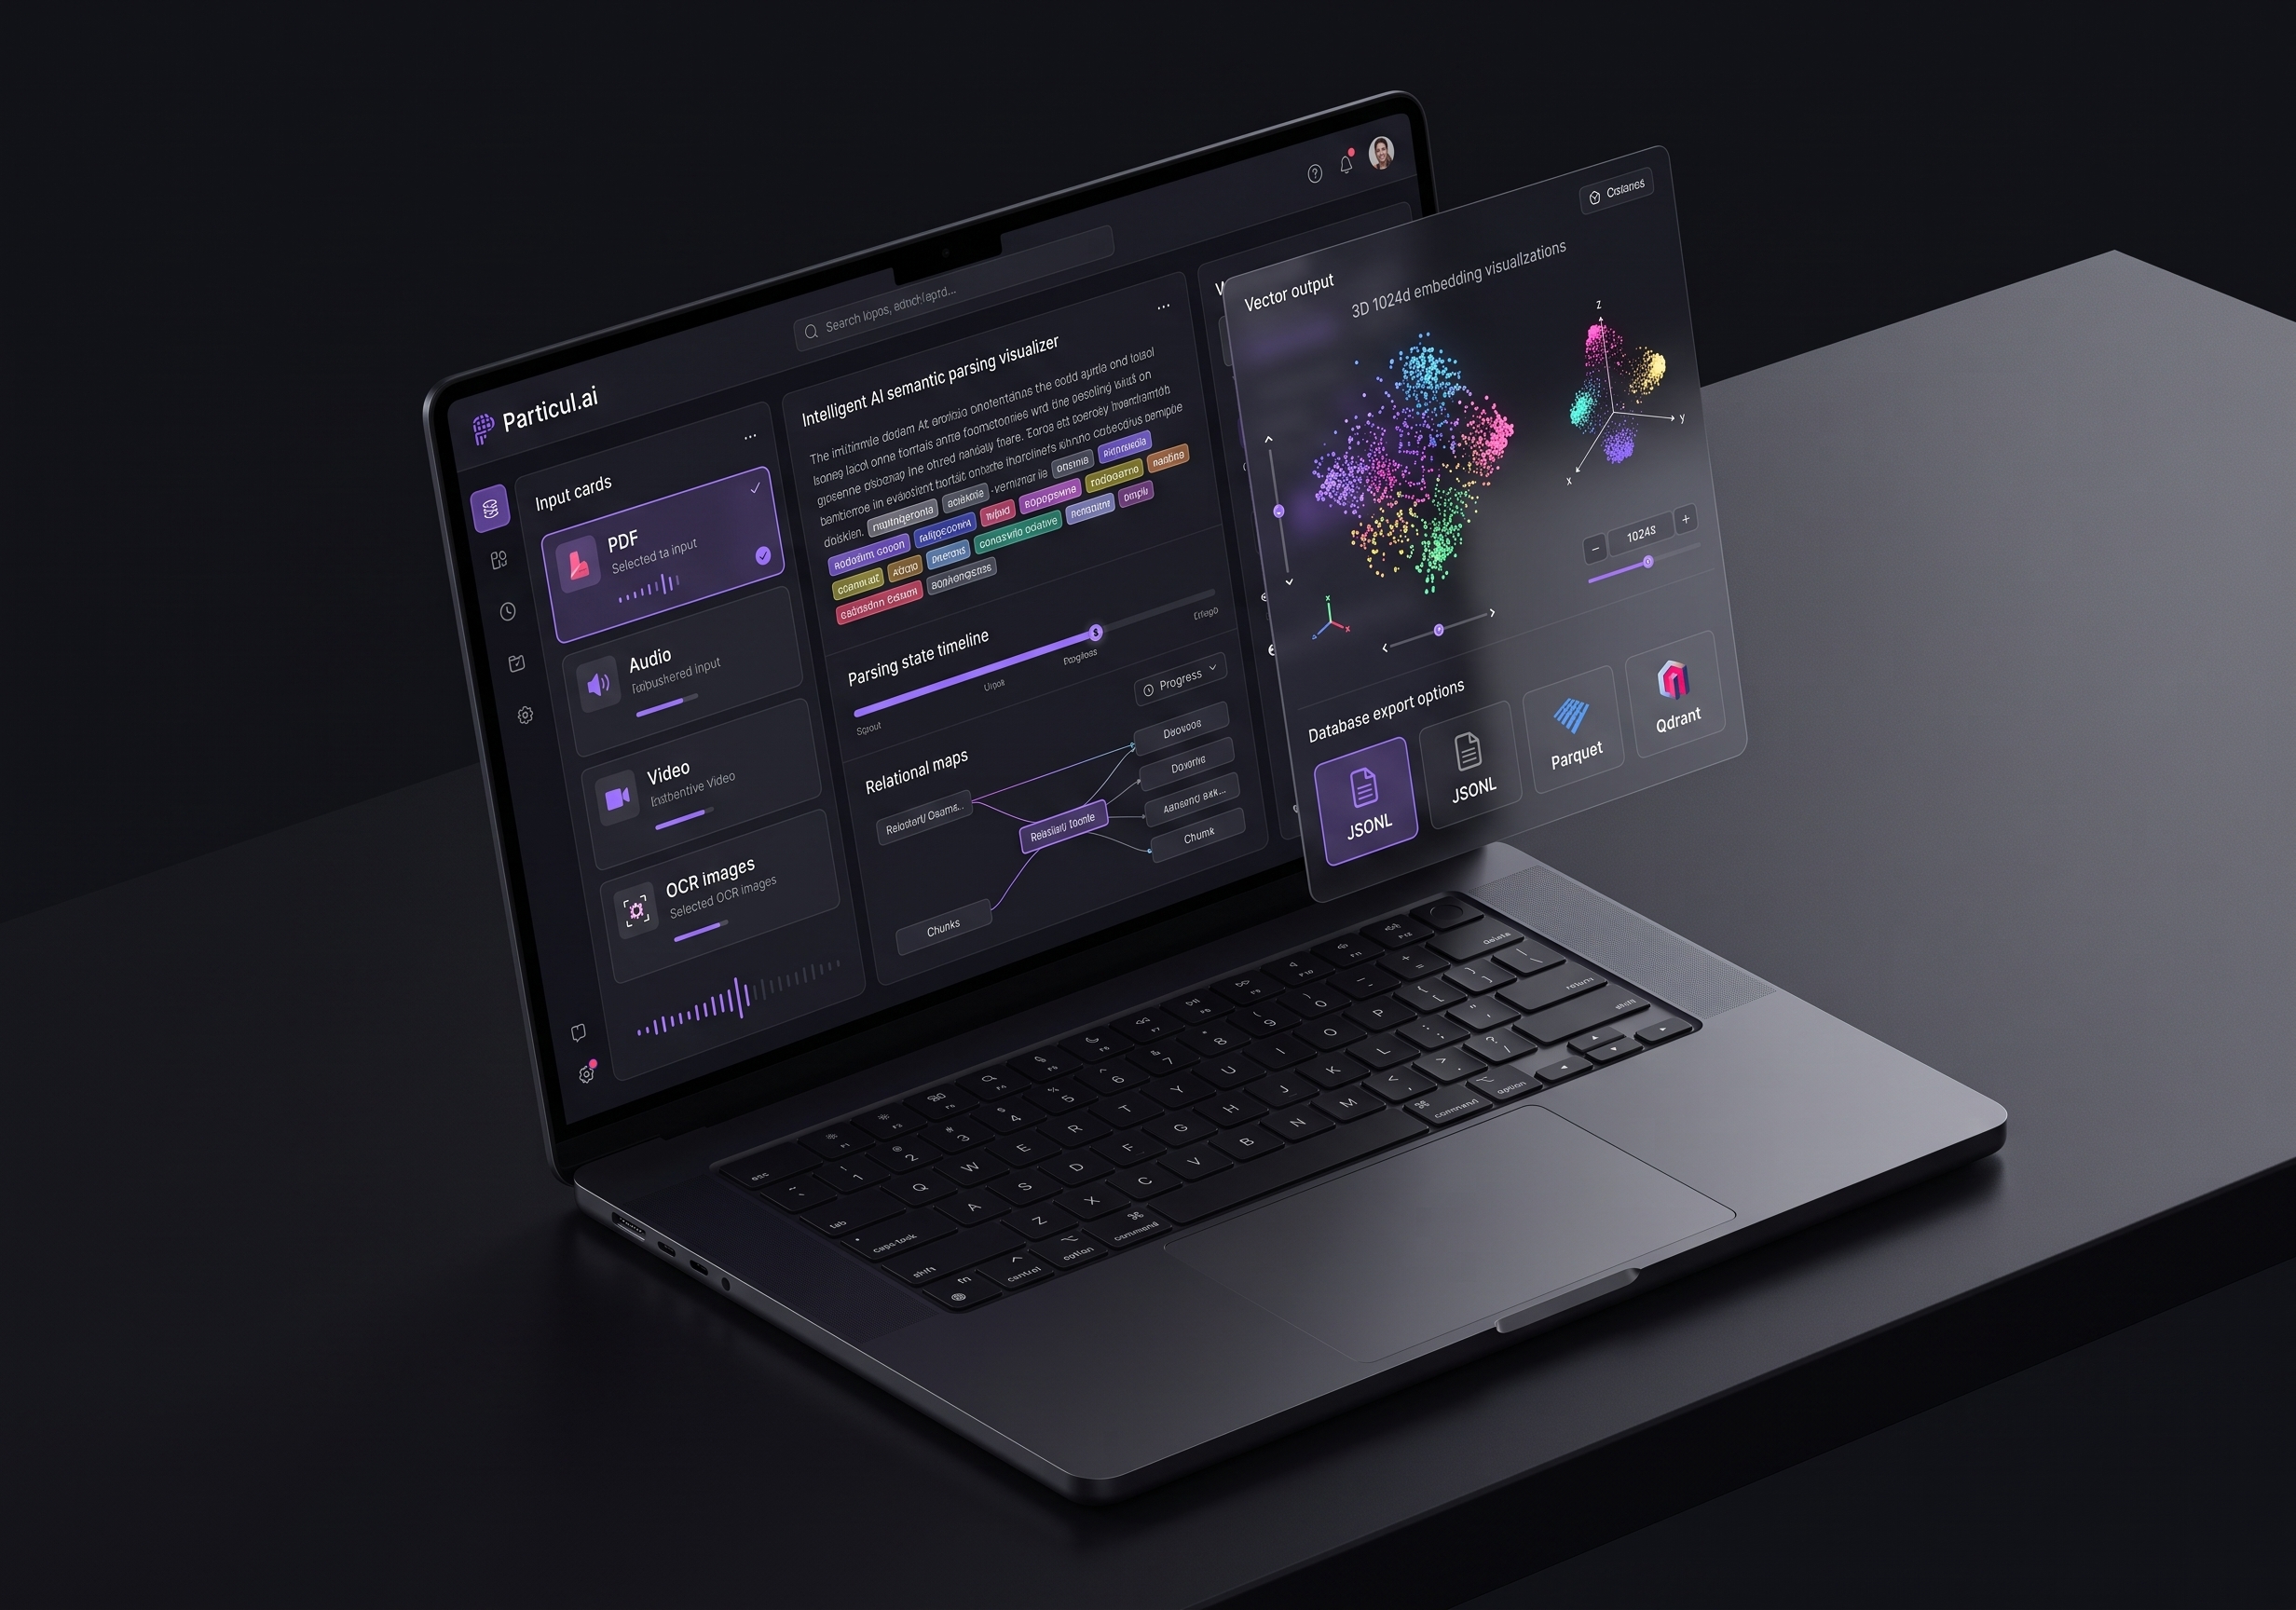
Particul.ai; farklı medya türlerindeki içerikleri tek bir arayüz üzerinden toplar, metne dönüştürür ve semantik bütünlüğü koruyarak parçalar. Üretilen embedding vektörleri, JSONL ve Parquet çıktılarıyla analiz, arama ve RAG sistemlerinde kullanılabilir.
İçeriği anlamlı bilgiye dönüştürmek
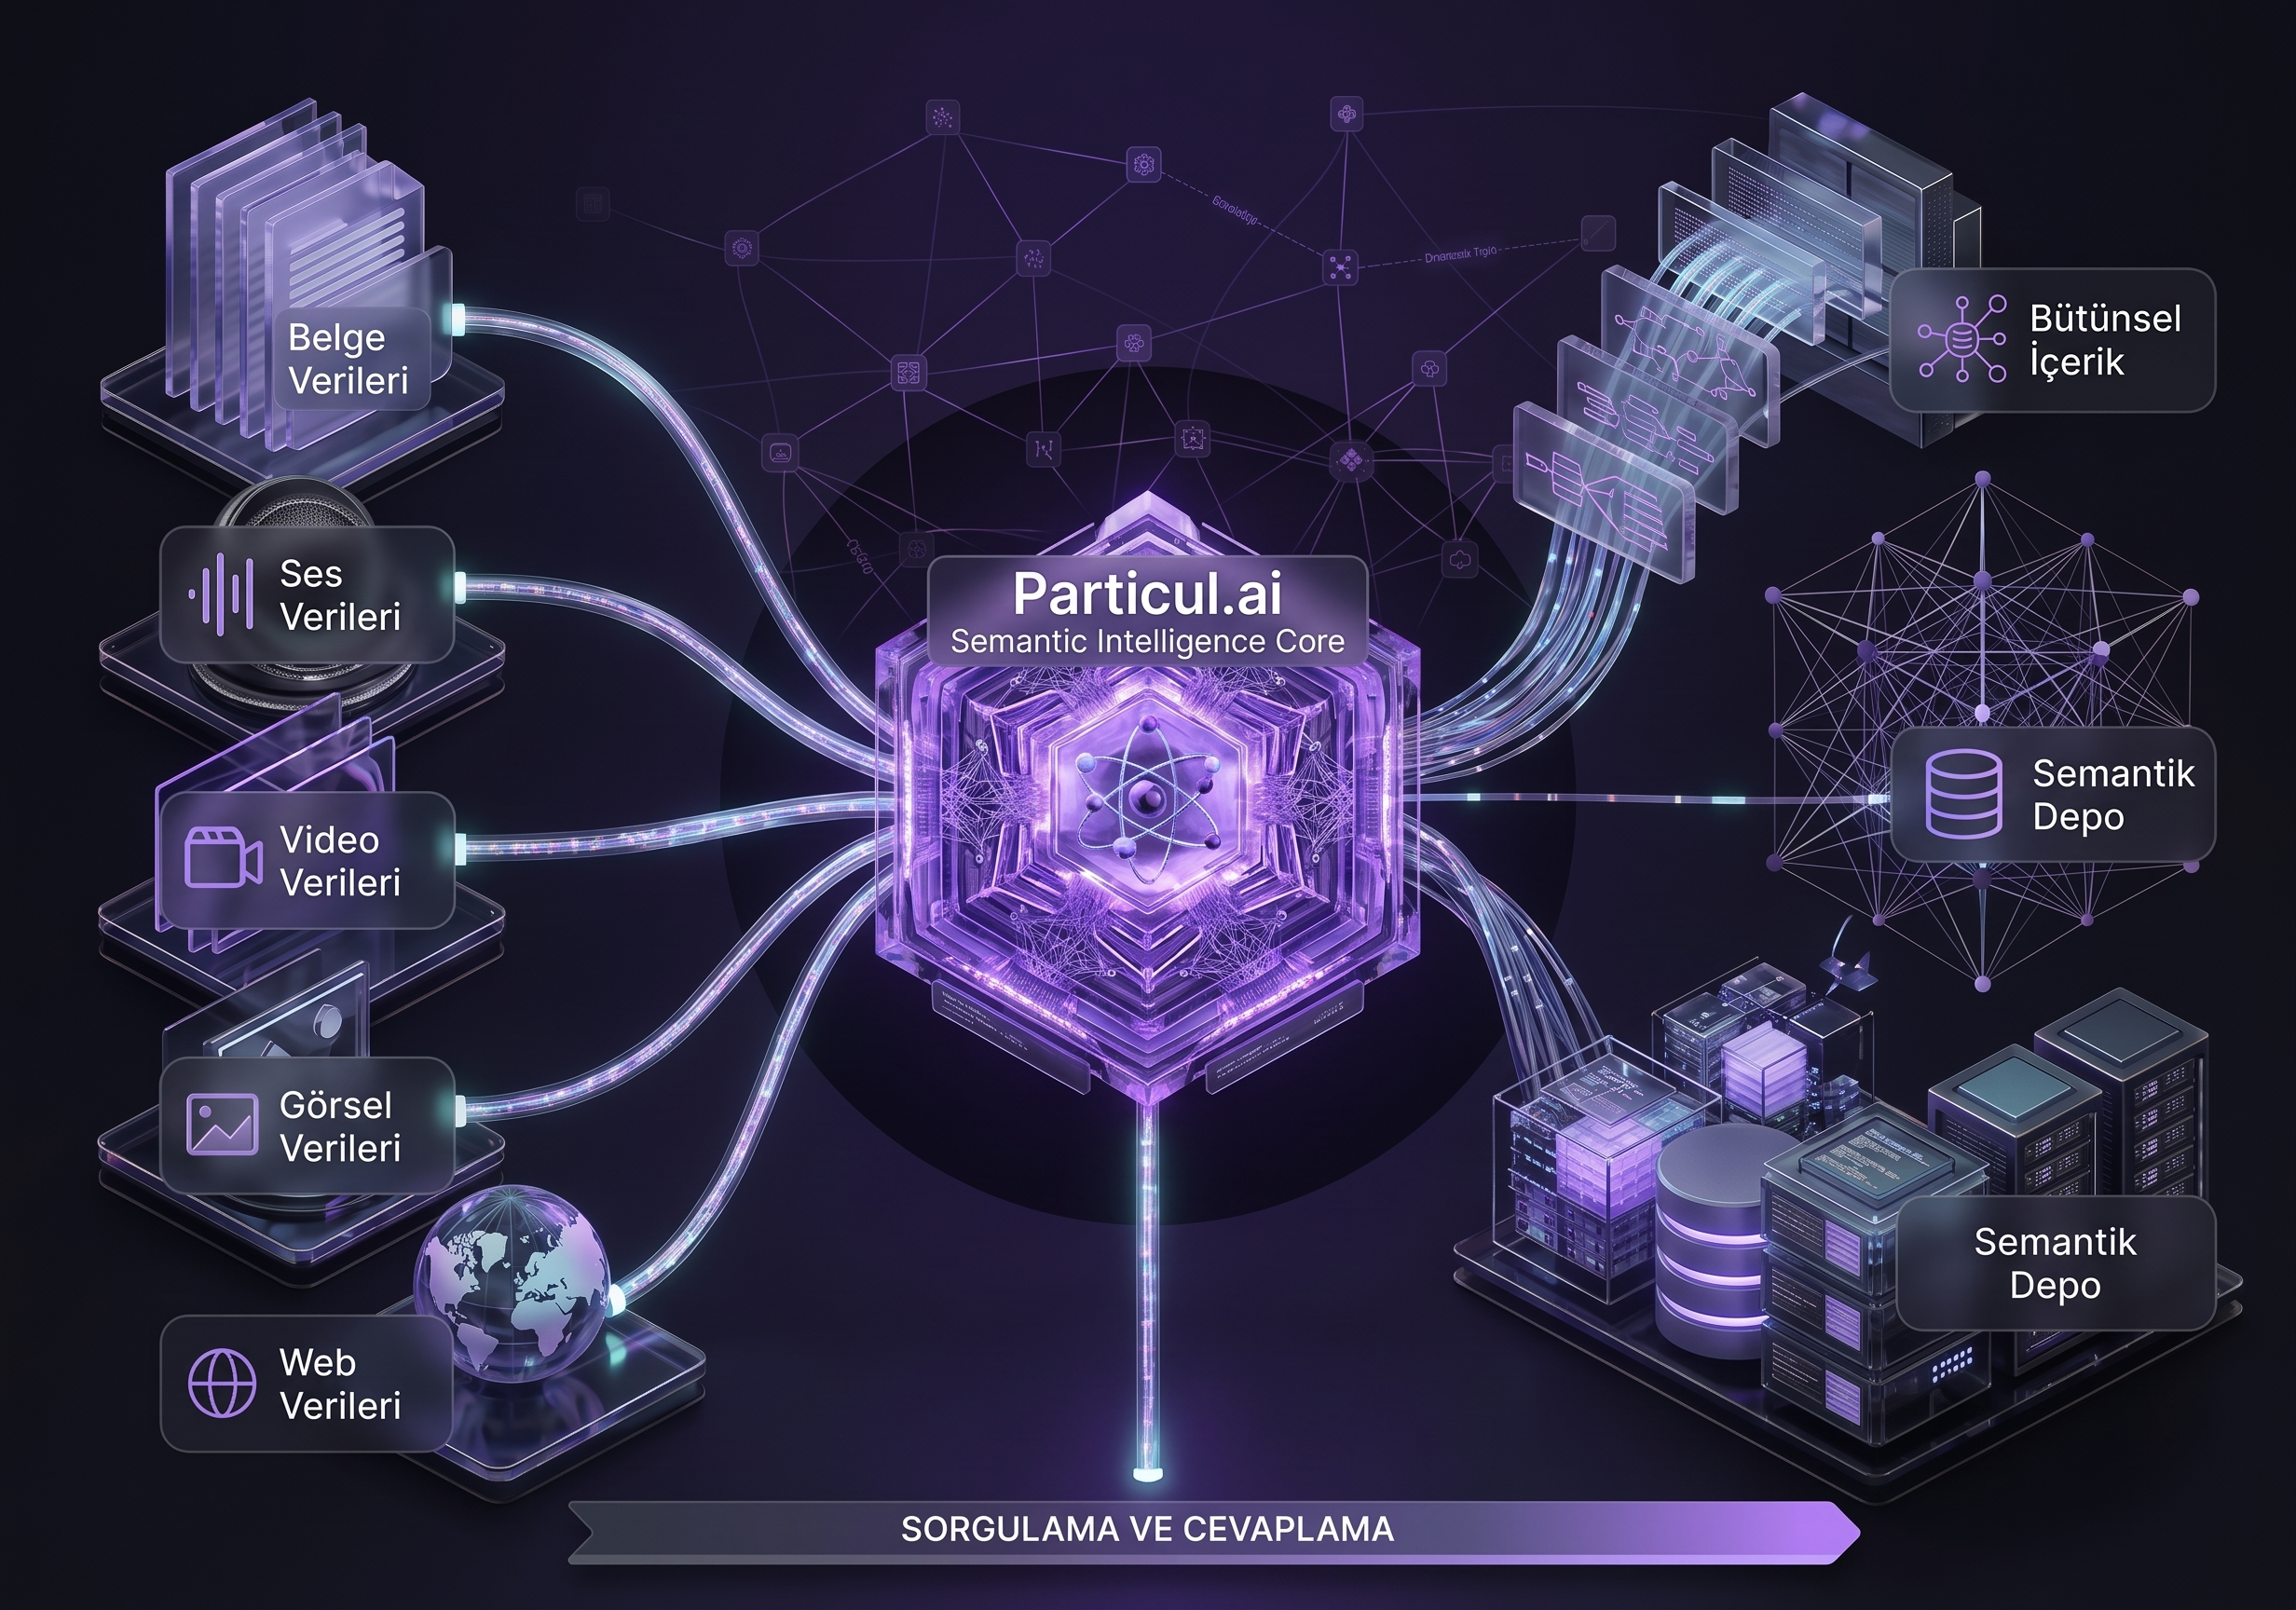
Particul.ai, farklı formatlardaki içeriklerin tek bir işlem hattı üzerinden işlenmesi fikriyle geliştirilmiştir. PDF, görsel, ses, video, YouTube bağlantısı, web sayfası ve metin dosyaları önce metinsel bir temsile dönüştürülür.
Projenin temel yaklaşımı, içerikleri sabit karakter aralıklarıyla bölmek yerine cümleler arasındaki anlamsal benzerliği analiz etmektir. BGE-M3 embedding modeliyle üretilen vektörler, içerik parçalarının Qdrant gibi vektör veritabanlarında aranabilir ve kullanılabilir hâle gelmesini sağlar.
Tek platformda çok kaynaklı içerik işleme
- PDF dosyalarından sayfa bazlı metin çıkarma
- Görsellerden Türkçe ve İngilizce OCR metni üretme
- Görseller için BLIP modeliyle otomatik açıklama oluşturma
- MP3, WAV, M4A ve benzeri ses dosyalarını Whisper ile yazıya çevirme
- Videolardan sesi ayırarak transkripsiyon yapma
- YouTube videolarının sesini indirip metne dönüştürme
- Web sayfalarından içerik çıkarma ve gerektiğinde Playwright ile tarayıcı tabanlı yedekleme kullanma
- İçeriği anlamsal chunk'lara bölüp BGE-M3 ile 1024 boyutlu embedding üretme
Hibrit anlamsal parçalama
Sistem önce içeriği paragraf ve başlık gibi yapısal sınırlara göre ön bölümlere ayırır. Ardından cümleler arasındaki embedding benzerliğini analiz ederek anlamsal kopuş noktalarını belirler. Çok kısa parçalar, anlamsal benzerlik korunuyorsa komşu parçalarla birleştirilir.
Semantic Chunking
İçerik anlamına göre bölünür
Sabit karakter sınırları yerine cümleler arası anlamsal benzerlik kullanılır. Böylece her chunk mümkün olduğunca kendi içinde tutarlı, arama ve RAG senaryoları için daha kullanılabilir hâle gelir.
Not: Chunk uzunluğu; benzerlik eşiği, minimum token ve maksimum token ayarlarına göre değişir. Üretilen sonuçlar kullanılan model ve kaynak kalitesine bağlıdır.
Modüler ve genişletilebilir veri hattı
Proje; kaynak yükleme, metin çıkarma, anlamsal parçalama, embedding üretimi ve dışa aktarma katmanlarına ayrılmış modüler bir mimari kullanır. Yeni bir kaynak türü, bağımsız bir loader eklenerek sisteme dahil edilebilir. Kullanıcı deneyiminde ise ilerleme durumu, işlem iptali, hata mesajları, sonuç önizlemeleri ve indirilebilir çıktılar öne çıkarılır. Böylece teknik bir veri işleme süreci, tarayıcı üzerinden takip edilebilir bir iş akışına dönüştürülür.
Anlamlı veriye dönüştürmeyi 4 adımda keşfet
01
Discover — Keşfet
PDF, görsel, ses, video, YouTube bağlantısı, web sayfası veya metin dosyasını sisteme aktarın. Sistem kaynağın türünü otomatik olarak algılar.
02
Extract — Çıkar
Kaynak içeriği uygun teknolojiyle metne dönüştürülür. OCR, Whisper, PyMuPDF, Trafilatura veya Playwright gibi araçlar kaynağın türüne göre devreye girer.
03
Chunk — Parçala
Metin; paragraf yapısı, cümle sınırları ve anlamsal benzerlik dikkate alınarak değişken uzunlukta chunk'lara ayrılır. İsteğe bağlı QA modu ile soru-cevap çiftleri birlikte tutulabilir.
04
Embed — Dışa Aktar
Her anlamsal parça BGE-M3 modeliyle 1024 boyutlu embedding'e dönüştürülür. Sonuçlar JSONL ve Parquet olarak indirilebilir, yapılandırılmış bir Qdrant sunucusuna aktarılabilir.
İçeriğinizi anlayın. Verinizi aranabilir bilgiye dönüştürün.
Farklı kaynaklardaki içerikleri tek bir işlem hattında birleştirin, anlamsal bütünlüğü koruyarak parçalara ayırın ve yapay zekâ destekli arama sistemleriniz için hazır hâle getirin.